Harness Handbook для ИИ-агентов: как карта поведения кода улучшает планы изменений
Качество ИИ-агента зависит не только от модели. Между запросом пользователя и редактированием кода находится «обвязка» — agent harness: она собирает промпты, управляет состоянием, вызывает инструменты и координирует выполнение. Новая работа Harness Handbook предлагает описывать такую систему через её поведение, чтобы агент быстрее находил места, которые действительно нужно изменить.
Почему обычной карты репозитория недостаточно
Репозиторий организован по файлам, модулям и функциям, а задачи формулируются на языке поведения: «изменить обработку разрешений», «маскировать секреты во всех путях записи» или «добавить параметр в цепочку выполнения». Одно поведение может проходить через схему, интерфейс, несколько веток исполнения и общий state. Поиск по ключевому слову находит заметные участки, но легко пропускает зеркальную реализацию, резервную ветку или редко выполняемый путь.
Индекс кода и большое контекстное окно помогают читать больше файлов, но не решают главную задачу автоматически: восстановить связь между требованием и распределённой реализацией. Авторы Harness Handbook называют этот этап behavior localization — локализацией поведения.
Как устроен Harness Handbook
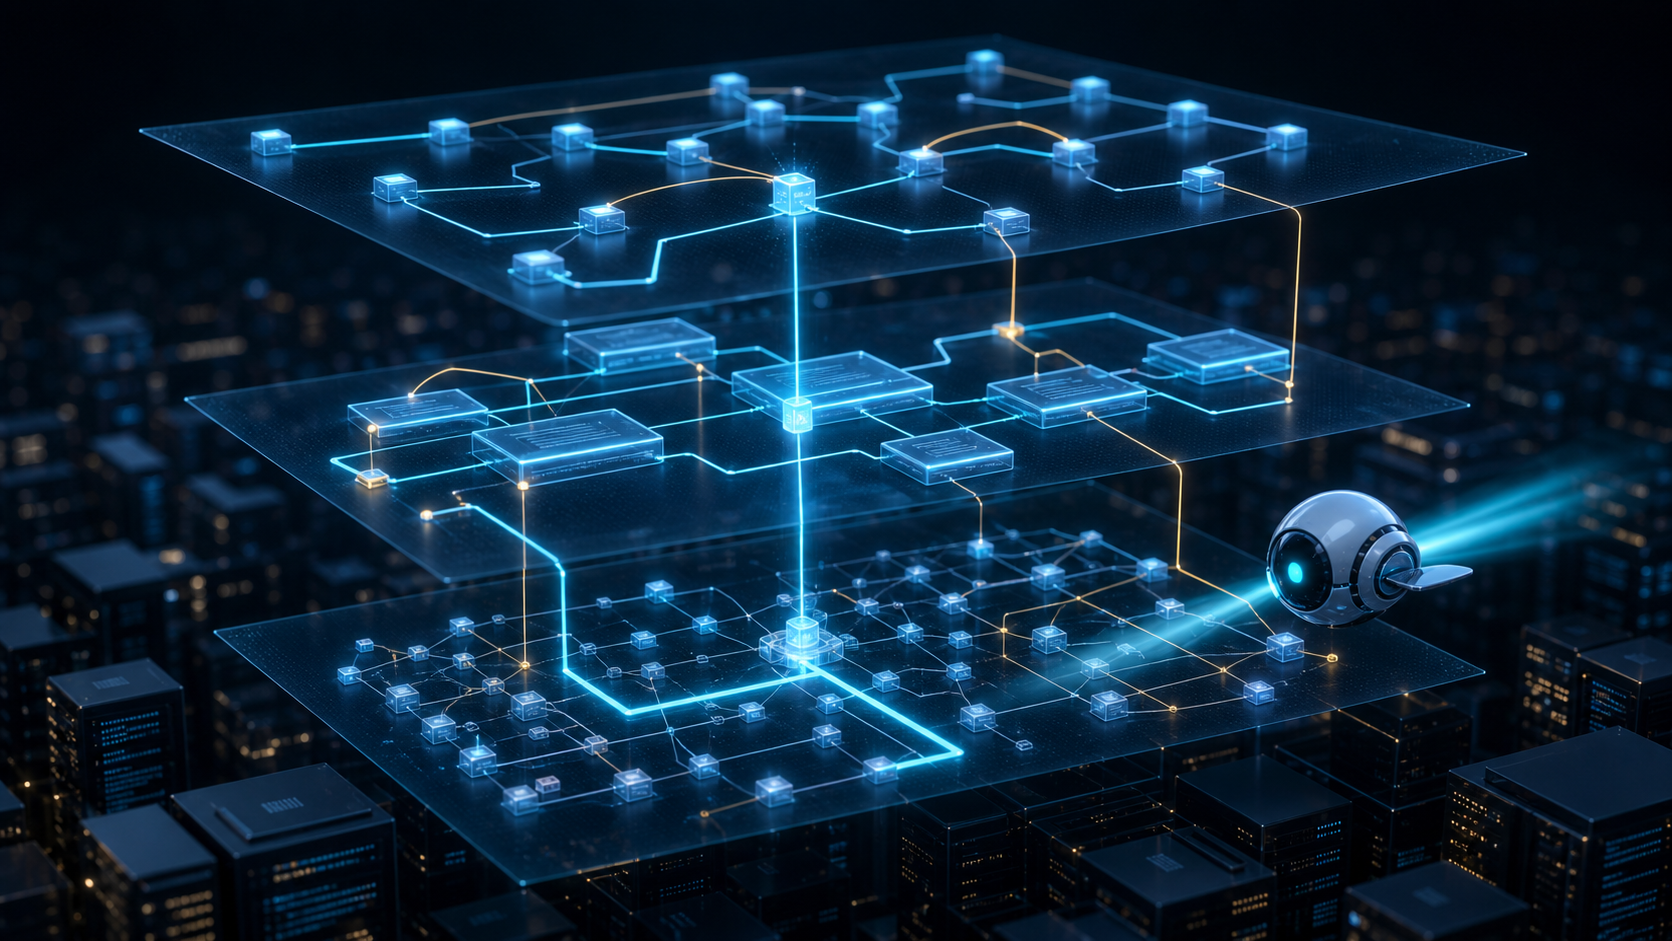
Предложение исследователей состоит из двух частей. Первая — иерархическая карта L1–L3. Уровень L1 даёт обзор системы, модели исполнения и глобального потока данных. L2 описывает отдельные этапы: их ответственность, входы, выходы, зависимости и локальное состояние. L3 привязывает поведение к конкретным файлам, функциям или диапазонам исходного кода.
Вторая часть — реестр состояния, который показывает связи, пересекающие границы этапов. Это важно для агентных систем: результат одного шага может попасть в память, затем изменить промпт, повлиять на разрешение инструмента и только потом проявиться в другой части программы.
Карту строят из репозитория. Сначала статический анализ извлекает функции, внешние границы, сигнатуры и разрешённые рёбра вызовов. Затем LLM помогает организовать элементы по этапам поведения и сформировать понятные описания. При этом исходный код остаётся источником истины: ссылки на реализацию перепроверяются, а неподтверждённые локаторы исключаются до обновления.
Принцип progressive disclosure
Агент не получает сразу всю документацию. Он идёт от общего уровня к подробному только по выбранному поведению: сначала определяет нужный этап, затем связанные компоненты и только после этого читает подтверждённые участки кода. Авторы называют этот процесс Behavior-Guided Progressive Disclosure. После непустого diff справочник синхронизируется с репозиторием, чтобы не превратиться в устаревшую архитектурную схему.
Что показал эксперимент
Метод проверили на двух открытых agent harness: компактном Terminus-2 и крупном Rust-монорепозитории Codex. Для каждой системы использовали 30 запросов на изменение поведения, включая обычные изменения, межфайловые задачи и сценарии, враждебные простому поиску.
В оценке качества планов доля побед варианта со справочником выросла с 28,3% до 38,3% на Codex и с 26,7% до 45,6% на Terminus-2. Одновременно средний расход токенов планировщика снизился на 12,7% и 8,6% соответственно. Наибольшую пользу авторы отмечают там, где реализация разбросана по файлам, находится в редко используемых ветках или пересекает несколько модулей.
Но результат важно читать правильно. Исследование оценивает локализацию мест изменения и качество плана, а не гарантирует, что агент затем создаст корректный патч и пройдёт тесты. LLM-судьи сравнивают планы, поэтому цифры нельзя напрямую превращать в обещание роста производительности разработки.
Что это меняет для команд разработки
Идея полезна далеко за пределами конкретного инструмента. Команда может завести поведенческую карту для сложной платформы: маршрутизация запросов, управление контекстом, политика инструментов, маскирование секретов, ретраи, логирование и завершение задач. Такая карта дополняет архитектурную документацию ответом на практический вопрос: где реализовано поведение и какие соседние участки обязаны меняться вместе.
Для интеграторов ИИ это особенно актуально. Agent harness быстро меняется вместе с моделями, API, ограничениями безопасности и бизнес-процессами. Документация по файлам устаревает, а поведенческие зависимости остаются неявными. Автоматическая синхронизация после diff может сделать такой справочник частью CI, но потребует контроля качества и правил обработки чувствительного кода.
Минимальный пилот
1. Выберите одно сквозное поведение, которое регулярно меняется и затрагивает несколько модулей.
2. Опишите его этапы, состояние, внешние границы и подтверждённые ссылки на код.
3. Дайте агенту сначала карту, а подробные файлы раскрывайте по мере локализации.
4. Сравните полноту найденных участков, качество плана, число лишних файлов и расход контекста.
5. После каждого изменения автоматически проверяйте, что все локаторы по-прежнему существуют.
Не стоит сразу документировать весь монорепозиторий. Ценность проявится там, где одна ошибка локализации дороже поддержки карты: безопасность, платежи, права доступа, агентные циклы, интеграции и общая инфраструктура.
Практический вывод
Harness Handbook показывает важный сдвиг в инженерии ИИ-агентов: следующая прибавка качества может прийти не от более крупной модели, а от лучшей организации знаний о системе. Поведенческая карта не заменяет тесты, ревью и проверку патча, но помогает агенту начать работу с правильных участков и не тратить контекст на бесцельный обход репозитория.