PDF без лишнего OCR: как pdf-inspector ускоряет обработку документов для ИИ
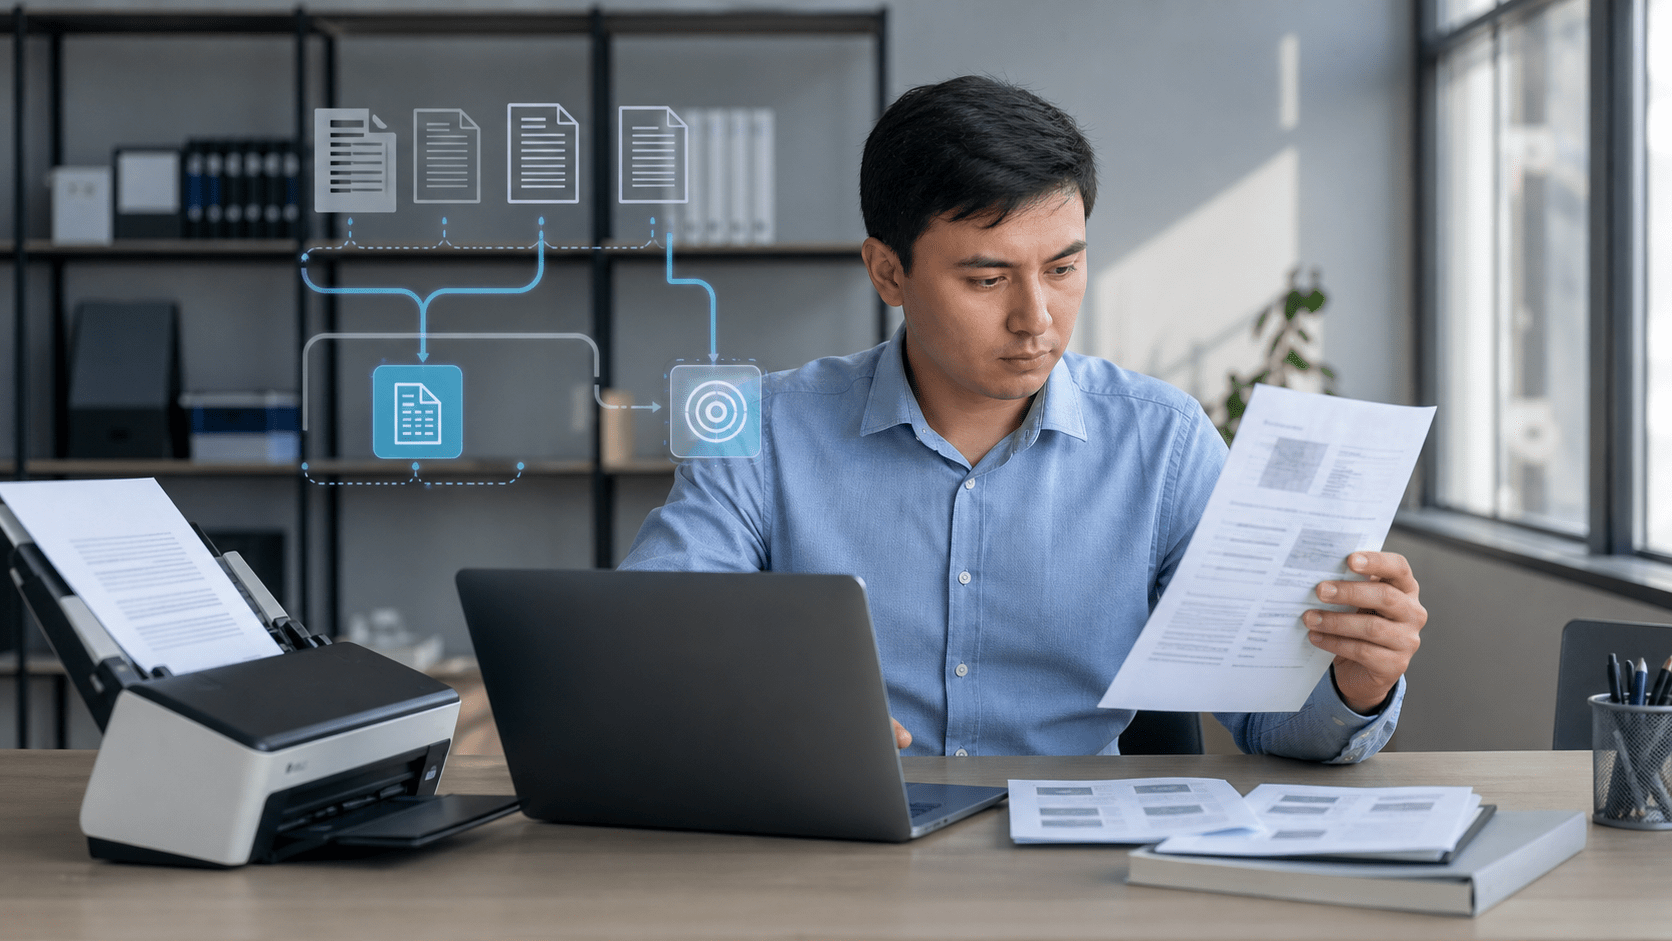
Компании часто начинают обработку PDF с самого дорогого шага: отправляют каждую страницу в OCR, даже если документ уже содержит пригодный для извлечения текст. Новый open-source-инструмент pdf-inspector предлагает сначала классифицировать файл, локально разобрать доступный текст и направить на оптическое распознавание только те страницы, где оно действительно требуется.
Проект написан на Rust и опубликован Firecrawl под лицензией MIT. Он может быть полезен разработчикам RAG-систем, корпоративных архивов, сервисов обработки счетов и договоров — особенно там, где важны задержка, стоимость внешних API и конфиденциальность документов.
Что делает pdf-inspector
Инструмент различает четыре типа файлов: текстовые, сканированные, состоящие из изображений и смешанные PDF. Для проверки он анализирует потоки содержимого страниц и наличие текстовых и графических операторов. Результат включает оценку уверенности и список конкретных страниц, которым может потребоваться OCR.
Если в PDF уже есть нормальный текстовый слой, библиотека извлекает его с координатами и сведениями о шрифтах, восстанавливает порядок чтения и преобразует документ в Markdown. Заявлена поддержка заголовков, списков, ссылок, многостолбцовой верстки и таблиц. При проблемной кодировке инструмент ставит флаг, позволяющий переключить такую страницу на OCR.
Это меняет базовую схему конвейера: вместо «PDF → OCR всех страниц → парсинг» применяется «PDF → классификация → локальное извлечение → OCR только выбранных страниц». В быстром маршруте нет LLM, SaaS и сетевых запросов. Библиотека доступна для Rust, Python, Node.js и браузера через WebAssembly; есть и командная строка.
Почему выборочный OCR выгоднее
OCR необходим сканам, фотографиям документов и страницам со сломанным текстовым слоем. Но для цифровых отчетов, исследований, договоров и счетов он может стать лишним этапом. Распознавание добавляет задержку, потребляет вычислительные ресурсы и иногда вносит ошибки в уже существующий текст.
Разработчики pdf-inspector утверждают, что на их потоке около 54% PDF не нуждаются в OCR. В README приведена ориентировочная схема: классификация занимает около 20 мс, локальное извлечение — около 150 мс, тогда как внешний OCR может занимать от 2 до 10 секунд. Эти показатели нельзя автоматически переносить на любую инфраструктуру: результат зависит от файлов, оборудования и выбранного OCR-сервиса.
В опубликованном сравнении на корпусе opendataloader-bench из 200 PDF версия 0.2.6 получила общий балл 0,875 и обработала набор за 0,470 секунды. Авторы сравнивали только локальные движки без модельного парсинга и с отключенным OCR. Результаты обновлены 31 июля 2026 года, а конфигурация и вывод оценщика вынесены в воспроизводимую ветку репозитория.
Где инструмент пригодится бизнесу в Узбекистане
Практический сценарий — внутренняя база знаний с RAG. В нее могут поступать инструкции, договоры, тендерные документы, финансовые отчеты и сканы актов. Предварительная классификация сокращает число страниц, уходящих во внешний сервис, а значит, помогает контролировать расходы и время индексации.
Локальная обработка особенно интересна банкам, телеком-операторам, государственным подрядчикам и интеграторам, работающим с персональными или коммерчески чувствительными данными. Сам по себе локальный парсер не гарантирует соответствие требованиям безопасности, но уменьшает поверхность передачи: текстовые документы можно разобрать внутри инфраструктуры, а на OCR отправлять лишь необходимый минимум — либо использовать локальный OCR.
Другие подходящие задачи: прием счетов и актов от контрагентов; загрузка нормативных документов в корпоративный поиск; подготовка PDF к разбиению на фрагменты для RAG; массовая миграция архивов в структурированный Markdown; первичная сортировка файлов перед более дорогим мультимодальным анализом.
Как встроить в рабочий конвейер
Минимальный пилот стоит строить не вокруг красивой демонстрации, а на репрезентативной выборке реальных документов.
1. Разделите документы по классам
Соберите цифровые PDF, чистые сканы, смешанные отчеты, таблицы, многостолбцовые документы и файлы с нестандартными шрифтами. Отдельно отметьте страницы, где правильный ответ известен вручную.
2. Добавьте маршрутизацию
Текстовые страницы направляйте в локальное извлечение. Страницы из pages_needing_ocr, файлы с низкой уверенностью и документы с ошибками кодировки — в выбранный OCR. После этого объединяйте результаты с сохранением номеров страниц и метаданных.
3. Проверяйте качество, а не только скорость
Для RAG важны порядок чтения, целостность таблиц, заголовки и ссылки, а не просто количество извлеченных символов. Измеряйте долю корректно восстановленных таблиц, пропущенные фрагменты, ошибки в числах и качество ответов конечной системы.
4. Оставьте безопасный fallback
Автоматическая классификация может ошибаться. Для юридически значимых, финансовых и медицинских документов нужен контроль качества: порог уверенности, повторная обработка спорных страниц и выборочная ручная проверка. Оригинал PDF следует сохранять неизменным для аудита.
Что важно учитывать
pdf-inspector не заменяет OCR: он определяет, где OCR можно не применять, и извлекает доступный текст. Рукописные материалы, плохие фотографии, сложная графика и поврежденные файлы по-прежнему потребуют специализированных инструментов. Таблицы и нестандартная верстка также нуждаются в тестировании на собственном наборе данных.
Проект активно развивается, поэтому перед внедрением стоит закрепить версию зависимости, проверить лицензию и политику безопасности, а обновления прогонять через регрессионный набор. Бенчмарки авторов полезны как отправная точка, но решение о продуктивном использовании должно опираться на измерения внутри конкретного процесса.
Вывод
Главная ценность pdf-inspector — не еще один способ распознать документ, а более рациональная архитектура. Сначала понять содержимое PDF, затем использовать самый дешевый и приватный маршрут, а OCR подключать адресно. Для команд, которые массово готовят документы к поиску, аналитике или ИИ, такой подход способен одновременно снизить задержку, стоимость и ненужную передачу данных.
Первоисточники
Репозиторий и документация pdf-inspector
Воспроизводимые результаты бенчмарка
Корпус opendataloader-bench
Материал носит информационный характер. Для документов с персональными, финансовыми, медицинскими или юридически значимыми данными необходимо отдельно оценить требования законодательства, договоров и внутренних политик безопасности.