Как превратить PDF и таблицы в базу знаний для ИИ: тестируем open-source MinerU
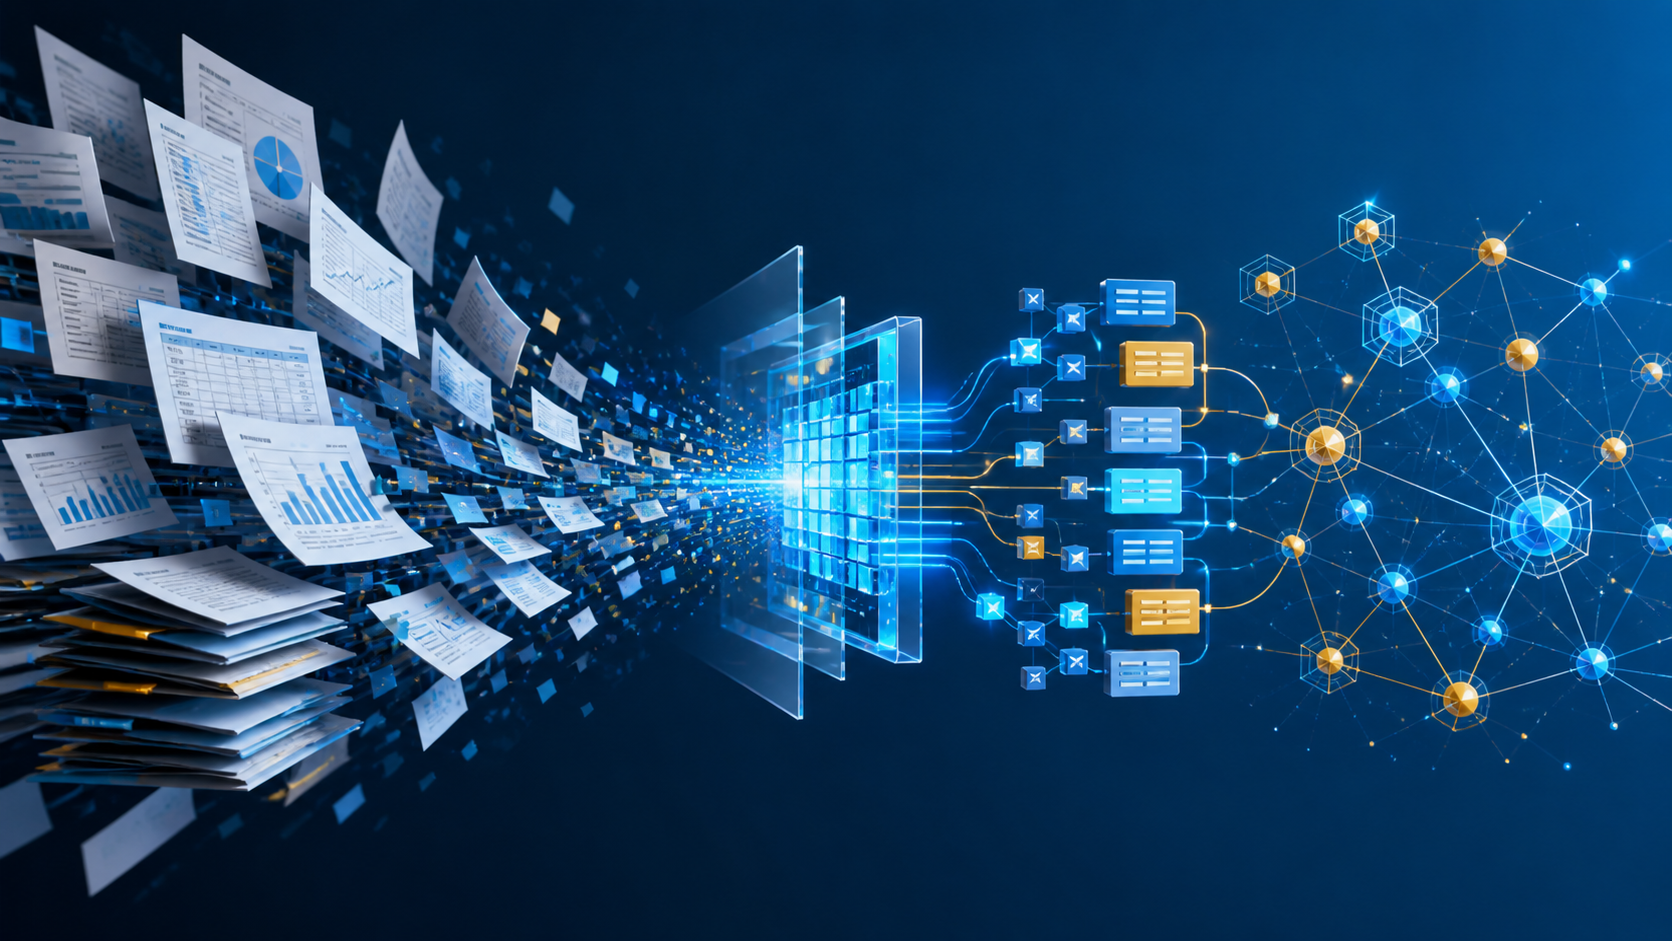
Большая часть корпоративных знаний хранится в неудобных для ИИ форматах: PDF со сложной вёрсткой, сканах, презентациях и таблицах. Open-source проект MinerU превращает такие документы в структурированные Markdown и JSON, которые можно индексировать и использовать в RAG-системах.
Инструмент поддерживает PDF, изображения, DOCX, PPTX и XLSX. Он умеет восстанавливать порядок чтения, распознавать таблицы и формулы, удалять колонтитулы и включать OCR для сканов.
Зачем нужен отдельный парсер
Обычное извлечение текста часто перемешивает колонки, заголовки, подписи и таблицы. В результате поисковая система получает фрагменты без контекста, а языковая модель отвечает на основе неверно собранного документа.
MinerU пытается сохранить структуру: заголовки, абзацы, изображения, таблицы и формулы. На выходе можно получить Markdown для чтения, JSON для дальнейшей обработки и визуальные файлы для проверки распознавания.
Базовый сценарий RAG
- Собрать документы и проверить права на их обработку.
- Преобразовать файлы с помощью MinerU.
- Удалить дубликаты, служебные страницы и устаревшие версии.
- Разделить текст на фрагменты с учётом заголовков, а не только количества символов.
- Добавить метаданные: источник, дата, версия документа и уровень доступа.
- Загрузить фрагменты в поисковый индекс и протестировать вопросы с известными ответами.
Локальное развёртывание
Проект предлагает CLI, API и веб-интерфейс. Базовая обработка может работать на CPU, для более тяжёлых режимов доступно ускорение на GPU. Локальная установка особенно интересна компаниям, которые не могут отправлять договоры, финансовые документы или персональные данные во внешний облачный сервис.
Однако локальность не делает систему автоматически безопасной. Нужно контролировать доступ к исходным файлам, временным каталогам, результатам OCR и индексам. В журналах обработки также не должно оставаться чувствительное содержимое.
Где возникают ошибки
Сложные многоуровневые таблицы, рукописный текст, низкое качество скана и нестандартные формулы остаются трудными случаями. Сам проект предупреждает, что результат на сложных документах может быть ниже ожиданий. Поэтому перед массовой загрузкой нужен тестовый набор, отражающий реальные документы организации.
Полезная метрика — не процент распознанных символов, а точность ответов RAG на контрольные вопросы с указанием источника. Иногда менее красивый Markdown даёт правильный поиск, а визуально аккуратный документ теряет важную связь между таблицей и заголовком.
Минимальный пилот
Возьмите 50–100 документов разных типов, подготовьте 30–50 вопросов и эталонные ответы. Сравните режимы парсинга, стратегию разбиения и модели эмбеддингов. Обязательно добавьте сценарий «ответа нет в документах»: система должна честно сообщать об отсутствии данных.
Вывод
MinerU закрывает важный, но часто недооценённый слой AI-проекта — подготовку документов. Он не заменяет управление знаниями и контроль качества, зато может значительно ускорить создание прототипа корпоративной базы знаний.
Источники: официальный репозиторий MinerU и описание проекта на arXiv.